Concern-Oriented and Ontology-Based Analysis of Information Systems (2010)
Considero questo testo la sintesi matura della linea di ricerca sviluppata con Crenguța Bogdan. Il metodo orientato alle concerns, la definizione ontologica dei concetti e la costruzione delle faccette confluiscono in un quadro unitario: un sistema informativo è visto come composizione di viste multifaccettate, ricavate dall’ontologia di dominio e da modelli UML ontologici delle conoscenze e credenze degli stakeholder.
Dati bibliografici
Autori: Crenguța Bogdan, Luca Dan Șerbănați
Titolo originale: Concern-Oriented and Ontology-Based Analysis of Information Systems
Anno: 2010; tipo: testo di sintesi / articolo esteso.
Contributo concettuale
- Definisce il sistema informativo come composizione di viste multifaccettate.
- Collega concerns, motivazioni semantiche, vocabolario degli stakeholder e ontologia di dominio.
- Presenta i modelli UML ontologici come collegamento fra ontologia formale e modellazione.
- Spiega il meccanismo di astrazione mediante il quale si ottengono le faccette.
- Applica il metodo a un caso di pubblica amministrazione, mostrando la sua portata generale.
Descrizione approfondita
Il testo affronta una difficoltà centrale nello sviluppo dei sistemi informativi: costruire modelli concettuali sufficientemente rigorosi, ma anche capaci di governare la complessità dei sistemi reali. La risposta proposta consiste nella suddivisione sistematica del modello secondo le preoccupazioni degli stakeholder, ossia attraverso un’analisi orientata alle concerns.
Il lavoro riprende le definizioni fondamentali. Una concern è una preoccupazione associata a un problema e manifestata da una o più persone interessate alla costruzione o all’evoluzione del sistema. Per renderla operativa occorre una specificazione di alto livello che metta in relazione la descrizione della situazione iniziale, la situazione finale desiderata e il ruolo dello stakeholder che esprime la concern.
Da questa base emerge uno dei risultati più importanti dell’intera serie: il sistema informativo è descritto come un’aggregazione di viste ottenute componendo faccette. Una faccetta non rappresenta un frammento scelto arbitrariamente, ma un’astrazione motivata dalle credenze e dalle conoscenze significative degli attori. Il tema delle viste e delle faccette, introdotto negli articoli precedenti, diventa così l’asse portante del metodo.
Un ruolo essenziale spetta alle motivazioni semantiche (semantic rationales) delle concerns. Non tutte le convinzioni o conoscenze possedute da uno stakeholder sono pertinenti: interessano quelle che giustificano la preoccupazione quando l’attore agisce in un determinato ruolo. Da tali motivazioni si estrae il vocabolario necessario a costruire l’ontologia di dominio.
L’articolo descrive un metodo esteso in 15 passi. I primi undici sviluppano il nucleo già formulato in precedenza: identificare stakeholder e concerns, classificarle, analizzarne le relazioni e le priorità, individuare motivazioni semantiche e concetti, analizzarne l’intensione, scegliere un’ontologia fondazionale e definire l’ontologia di dominio. Gli ultimi quattro passaggi sono dedicati alle viste: costruzione dei modelli UML ontologici, derivazione delle faccette, analisi della loro indipendenza e aggregazione in viste.
Un modello UML ontologico è un diagramma delle classi che descrive in modo semiformalizzato il significato di una conoscenza o di una credenza pertinente alla concern. L’ontologia non resta così confinata in una struttura logica astratta, ma viene espressa in una forma più vicina agli strumenti della modellazione utilizzati nell’ingegneria dei sistemi.
Successivamente interviene l’astrazione: dai modelli UML ontologici si scelgono le classi e le relazioni che devono essere presenti nel modello di dominio del futuro sistema informativo. Alcuni elementi che derivano soltanto dalle categorie dell’ontologia fondazionale vengono filtrati, purché la loro rimozione non comprometta il significato della faccetta. Si ottiene quindi una struttura più semplice, ma semanticamente fedele alla concern di partenza.
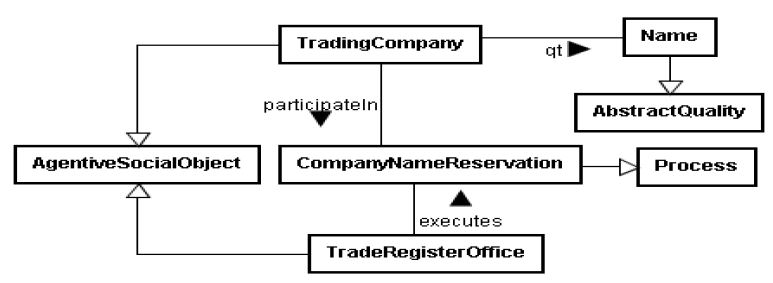
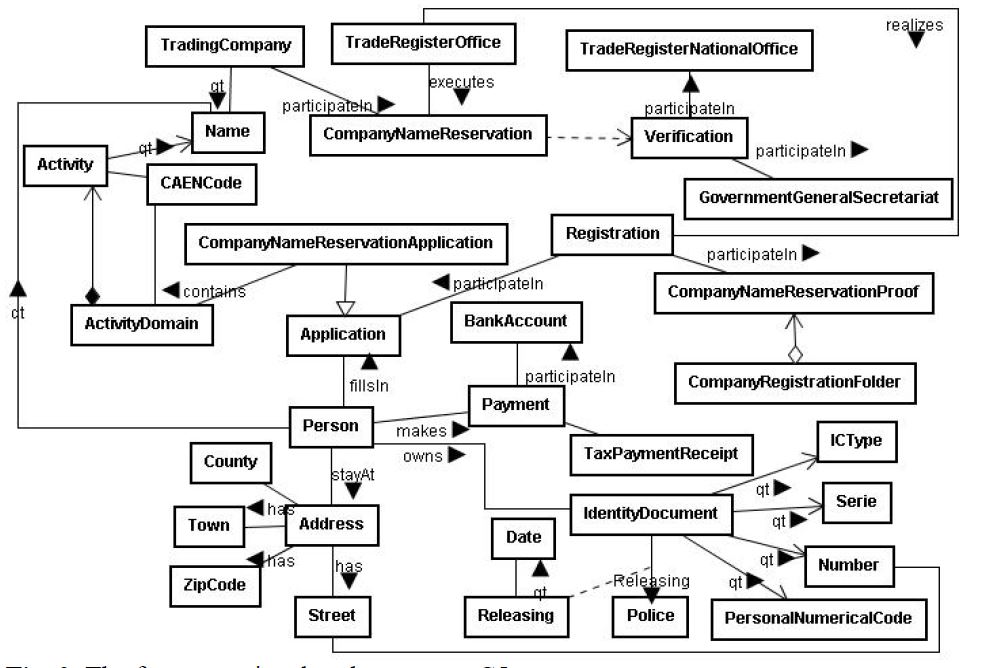
Il caso di studio allarga il campo rispetto agli esempi precedenti, spesso tratti dagli studi clinici. Si considera un sistema informativo destinato alla registrazione di una nuova impresa nella pubblica amministrazione romena. Vengono individuati diversi stakeholder — fondatori, amministratori, avvocati, giudici, funzionari e fornitori di servizi — e 31 concerns. Per la concern C5, riguardante la scelta del nome della nuova impresa, sono presentate credenze e conoscenze pertinenti, il modello UML ontologico associato alla conoscenza K5 e la faccetta risultante.
La scelta dell’esempio dimostra che il metodo non è limitato all’informatica medica, ma può essere impiegato più in generale nell’analisi dei sistemi informativi. Gli autori richiamano inoltre una possibile applicazione alla gestione longitudinale delle cartelle sanitarie elettroniche, collegando questo studio alle successive ricerche sulla sanità digitale.
Nella prospettiva dell’intera serie, il lavoro del 2010 integra in una sola architettura concettuale le nozioni di concern, motivazione semantica, ontologia di dominio, modello UML ontologico, faccetta e vista multifaccettata. I concetti non sono più proposte isolate, ma parti coerenti di un unico metodo.
Collocazione nella ricerca
Considero questo testo la sintesi delle ricerche condotte con Crenguța Bogdan. Il lavoro del 2006 ne costituisce il punto di partenza, quello dedicato a Understanding Concerns with Ontologies chiarisce la struttura teorica, mentre lo studio del 2007 sulla costruzione delle faccette introduce il meccanismo di modellazione. Nel 2010 questi elementi vengono riuniti in una formulazione più completa.
Per me il significato è anche più ampio: esprime una questione affrontata per molti anni nella ricerca e nell’insegnamento, ossia come ordinare la complessità di un sistema attraverso una pluralità di viste coerenti, senza perdere la semantica del dominio né cadere in scelte arbitrarie.
Collegamenti
Figure dell’articolo
Miniature: fare clic per ingrandire le immagini


Fig. 1. Modello UML ontologico della conoscenza K5 del caso di studio.
Fig. 2. Faccetta associata alla concern C5, ottenuta per astrazione dai modelli UML ontologici.